 我很喜欢在思源笔记里写 daily notes,也很讨厌为了记一句话,专门把手机掏出来。 今天发生了什么,孩子又有了什么变化,或者突然冒出来一个想法,我都希望留一点记录。这些内容往往很短,当下说得清楚,过一会儿再回想,就只剩一个模糊的印象。 但从“我想记一下”到真正写进笔记,中间还有一串动作:掏手机、解锁、打开思源、找到当天的日记,再开始输入。以前用思源手机端时,体验也有些不顺手。事情明明不大,做完这几步,想记录的热情已经被磨掉了一截。 所以看到千问 AI 耳机出来的时候,我首先想到的就是: > 我能不能直接说话,让它把内容记进我的思源? 我希望保留自己原来的笔记习惯:内容还在自己的思源里,同一天继续追加到同一篇日记。我只想把输入这一步变得省事一点。 这篇文章,就是围绕这个想法的一次实际折腾。日记写入已经有过真机口述、思源回读都对得上的记录,日常使用中也依然会卡壳。下面这些截图,来自我自己的使用过程。 ## 先记进去 我的思源部署在自己的服务器上,有可访问的 HTTPS 地址。通过千问硬件开放平台,我给耳机接了一个私有 Skill,让它在听到明确的记录要求后,调用思源接口,把口述正文追加到指定笔记本的当天日记。 测试时,我还说过一句“我很快乐”。这句话没什么技术含量,但后来回读思源,正文和返回标识都对得上。再往后,正式的 daily notes 也有了实际写入并回读成功的记录。 耳机这一侧接的是千问的工具调用;已经验证的日记写入走 HTTP API。思源的原生 CLI 则提供了另一种操作自己工作空间的方式,可以在电脑或服务器上执行,再把需要的操作封装成千问可调用的工具。 这一步的意义不止于用耳机操作原本就在使用的笔记系统:通过思源这个案例可以进一步推断,耳机有望成为触发自定义服务的入口,从而在不改变既有工作流的前提下,调用和串联更多个性化能力。 ## 自己动手改 思源是开源的,提供 API,也有原生 CLI。搜索、读写文档、每日笔记、引用关系、导入导出,都有可以继续利用的程序接口。配合 ChatGPT,我可以描述需求、查接口、改代码、测试,再把合适的功能接到耳机上。[思源官方 CLI 说明](https://github.com/siyuan-note/siyuan/blob/master/README.zh-CN.md) 所以,翻旧笔记、听内容、文档漫步,都是我沿着这条链路主动去设计的功能。日记只是最初的入口。只要语音到自己服务的链路能走通,我就能在自己的服务这一侧继续 DIY,再逐项验证耳机用起来是否合适。 现在这个“思源助手”,我给它安排了四件事: - 记日记:把明确要求保存的口述原文,追加到当天的日记。 - 找笔记:用关键词搜索自己的笔记,先告诉我找到了哪几篇。 - 听内容:选一篇概括,或者分段读原文。 - 文档漫步:从当前笔记继续找下一篇,支持继续读、换一篇、回到上一篇。 ## 听听旧笔记 我更在意的场景,是散步或骑车时,能顺手听听自己以前写过的东西。手机留在口袋里,随口说一个主题,让它找出几篇,再挑一篇听。那些写完以后很少再打开的记录,也就多了一个重新翻出来的机会。 这次我拿自己的旧日志试了试:搜到相关记录,概括指定笔记,继续听内容,再从当前这篇往下一篇“漫步”。下面这些,是当时成功接上的几个片段。 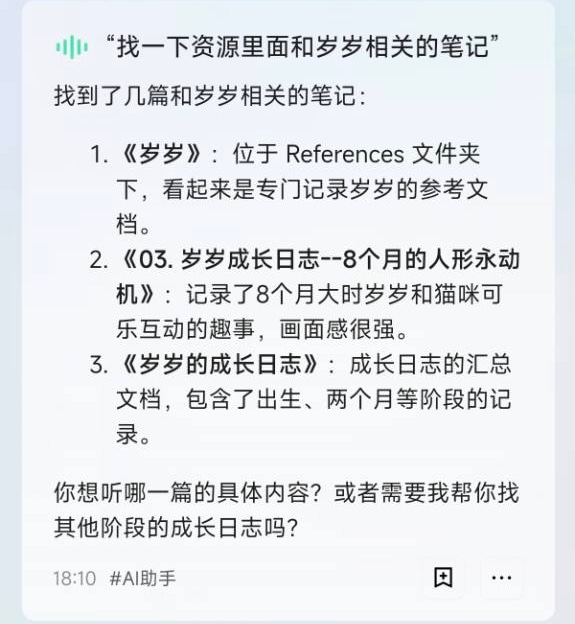 *先找出来:搜索返回了具体标题和位置,我可以据此选择想听的内容。* 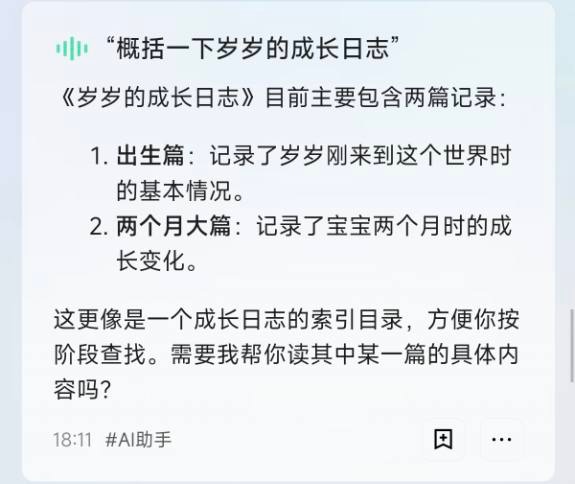 *再看大意:明确说出笔记标题后,它概括了这篇成长日志的目录。* 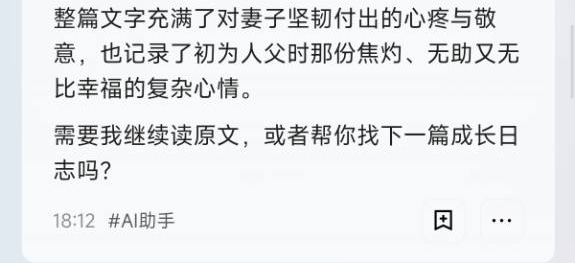 *继续听内容:这是阅读回复的节选,后面还能接着要求读原文。* 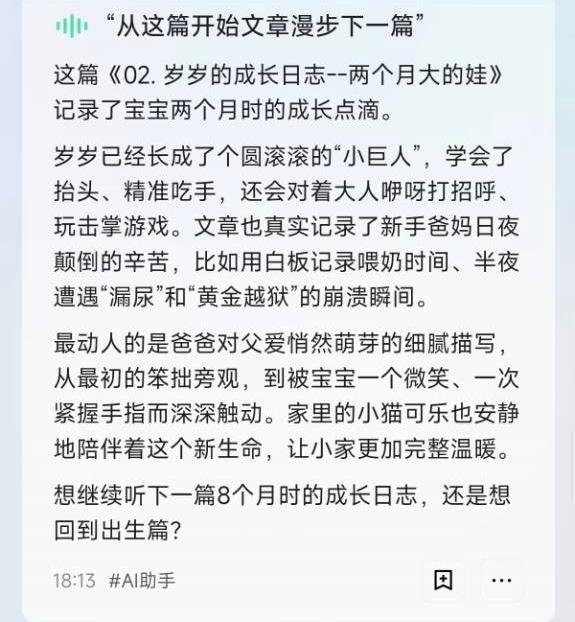 *顺着往下走:说“从这篇开始文章漫步下一篇”,它接着讲了下一篇记录。* 我喜欢的是这种重听自己记录的方式。散步时想起一个主题,或者骑车时忽然想回顾一段经历,不必先决定要打开哪个文件夹。听到熟悉的片段,还可以接着问、换一篇;如果又冒出新想法,就明确说一句,把它补进今天的日记。 ## 骑车时聊什么 那次使用里,我还让它看看知乎热榜,聊了一条关于 DeepSeek 的新闻,后来又一路聊到《塞尔达传说:王国之泪》。 这些话题之间没什么严密的计划。我想到哪儿,就问到哪儿。热榜里有一条感兴趣的内容,可以继续追问;游戏里某段剧情没想明白,也可以接着聊。 值得表扬的是,收音很准,风噪几乎没有影响,沟通很顺畅。Qwen 3.8 Flash 应对日常的 Chat 得心应手。 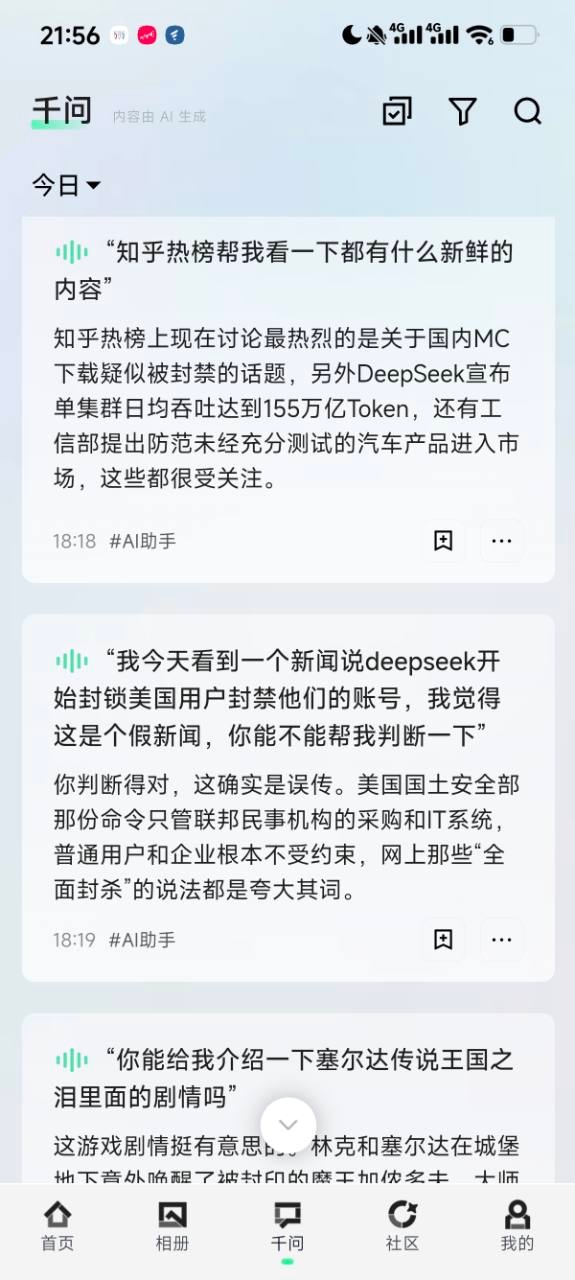 *从知乎热榜聊到新闻疑问。截图保留的是当时的回答,里面的具体消息不能直接当作已经核实的事实。* 比如聊塞尔达时,我会问:林克和塞尔达为什么会在地下遇到加侬多夫?《王国之泪》和《旷野之息》是什么关系?再往下,又聊到时间线、格鲁德族,以及游戏里的支线人物。 对我来说,这种随口追问的方式挺自然。一个问题讲完,我往往又有了下一个问题,耳机可以顺着接下去。手机可以留在口袋里。 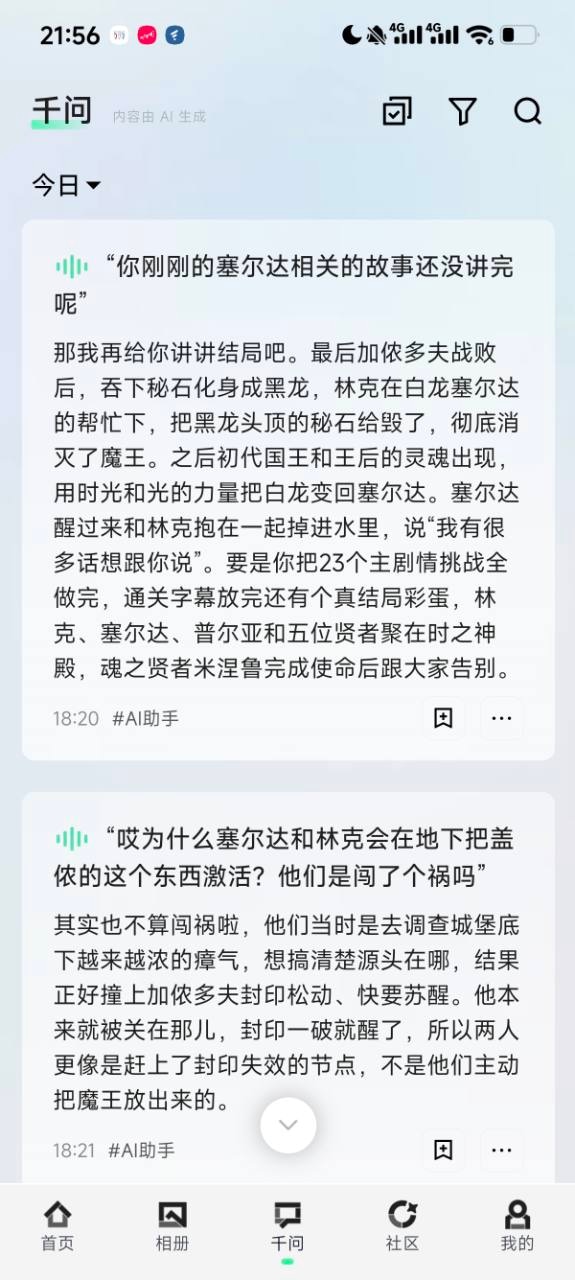 *一句“你刚刚还没讲完”,可以把话题继续接回来。截图涉及《王国之泪》剧情。* 不过,聊得顺不代表每句话都可靠。 有一个很明显的例子:我问的是“DeepSeek 是否开始封禁美国用户”,它回答的却是“美国政府是否限制使用 DeepSeek”。谁限制谁,方向变了,但它仍然很肯定地说“你判断得对”。 这种回答在耳机里尤其容易被顺着听过去。语气自然,信息也很多,稍不留意就会把它当成已经查明的结论。以后遇到新闻核查,我会更在意它有没有说清楚来源、日期,以及是否真的回答了原来的问题。游戏设定也一样,可以边聊边理解,具体细节仍有必要核对。 还有一个挺有意思的片段:我让千问把这次使用整理成一份 Markdown 文档。它先说需要一点时间,我随后继续聊游戏;过了一会儿,耳机里传来她告诉我任务写好了的通知。 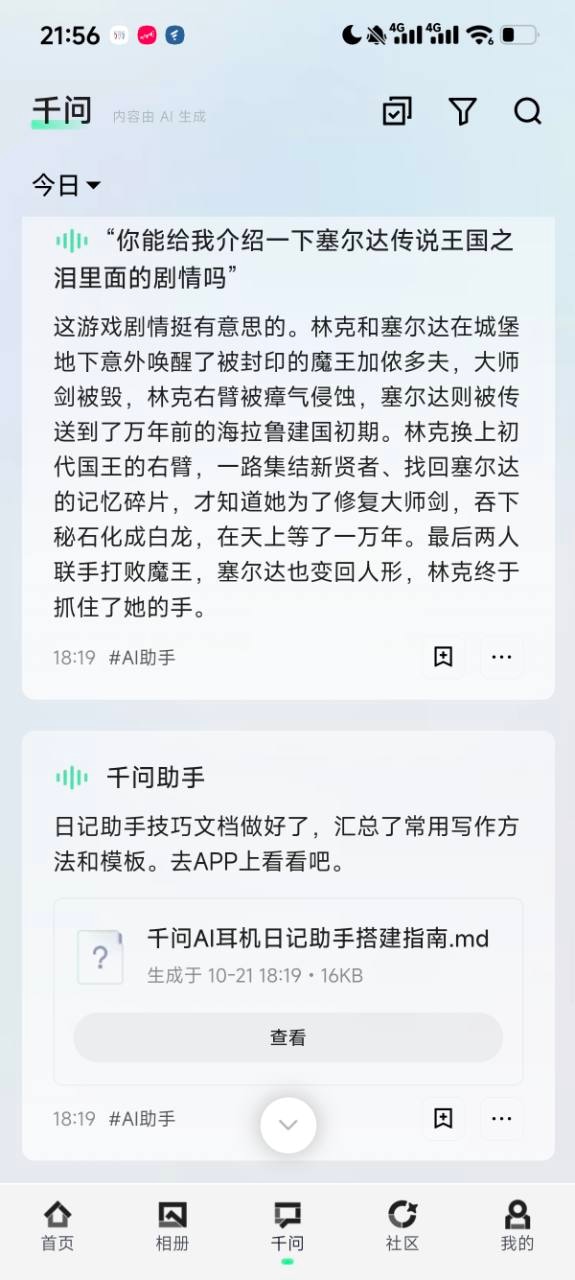 *耳机里听到完成通知后,App 里也能看到生成的 Markdown 文件卡片。* 我喜欢这种用法:当下把想法说出来,长一点的内容留到方便的时候再看。当前这种异步让远程 Agent 代理干活的模式,还是比较实用的。 ## 也有不顺 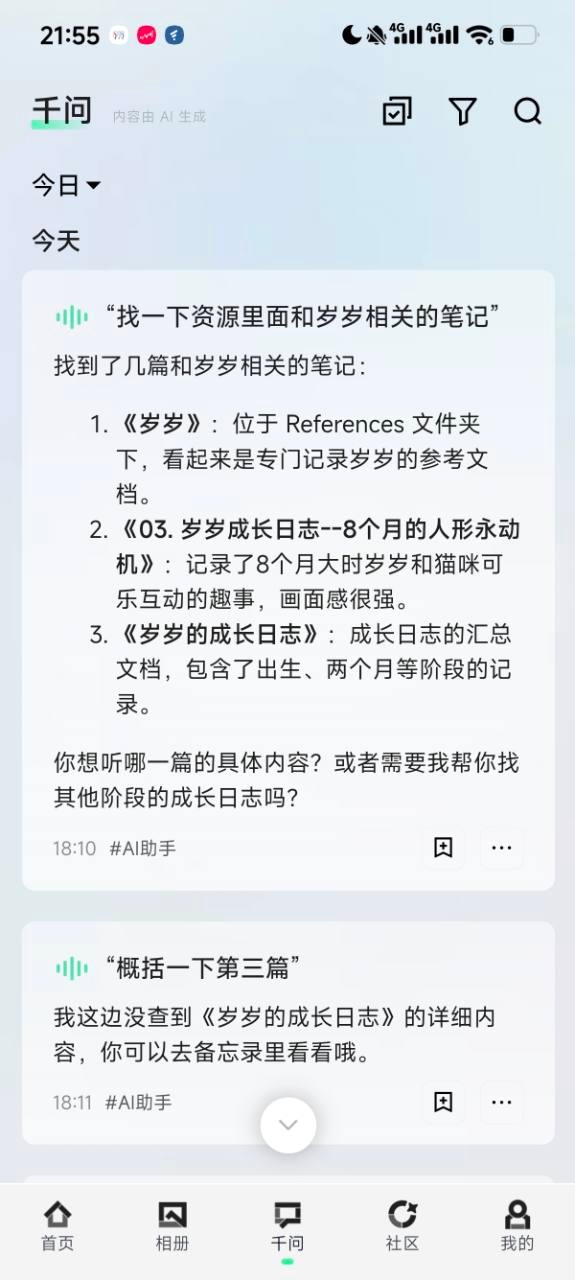 *搜索返回了具体笔记;紧接着“概括一下第三篇”又没有接住。顺畅和卡壳,都在同一段真实记录里。* 这里也能看到问题:它有时能找到标题,却接不住“第三篇”“第二篇”这样的追问;换成完整标题,或者继续尝试,又能读出内容。 这类体验会打断兴致。原因可能包括 Skill 没有把候选编号和文档对应关系处理好、工具读取失败,或者上下文切换出了问题。还需要进一步定位。对使用者来说,感受很直接:我刚听完它列出的三篇,再说“第二篇”,它应该知道我指的是哪一篇。 这次还有一段很拧巴的体验。 我明确说了“写思源笔记”,App 中却显示成了系统“备忘录”。它随后问我要不要创建提醒,我说“不需要”,接下来又收到“已追加到思源今天的日记”的回复。 站在使用者的角度,我当时想做的事情很简单。但这几句来回,让“到底记到哪里了”变得不清楚。 这可能和我的 Skill 触发描述、对话规则写得不够周全有关,也可能涉及平台如何在不同能力之间选择,或者前一轮结果返回的时间。现在不能把原因全部推给某一边。 我能做的,是把规则写得更明确:哪些说法进入思源日记,哪些只是聊天;原文怎么保留;工具失败时怎么回答;只有拿到真实成功结果,才说已经写入。测试时还要回到思源核对,不能只听一句“记好了”。 ## 怎么接入 千问硬件开放平台提供了 Skill 开发、工具接入、调试和真机测试等入口,也支持把已有 API、MCP 等服务接成模型可以调用的工具。我这次先走的是 API 插件加私有 Skill 这条路线。[平台介绍](https://device.qianwen.com/docs/qwen/6679322) 整个调用过程可以简单理解为: > 对耳机说话 → 千问理解请求并选择 Skill → 调用配置好的外部工具 → 自己的服务执行操作 → 千问根据结果回复 想照着试,可以按下面的顺序来。 1. **准备自己的服务。** 对思源来说,需要自己的访问地址、API Token,以及明确的目标笔记本。地址要能被千问云端访问;电脑上只有一个本机地址,还不能让云端连进来。建议先用一个专门的测试笔记本。 2. **在开放平台创建 API 插件。** 进入[千问 AI 硬件开放平台](https://device.qianwen.com/),按页面要求完成开发者准备,在技能平台的“API 插件”里配置服务地址、认证方式和具体接口。地址、Token 都用自己的,不把私人凭证写进公开的 Skill 文本。 3. **把一次操作定义清楚。** 比如“追加当天日记”,只需要从口述中提取要记录的正文;目标笔记本固定在工具配置里。先在工具调试中验证它能写进正确的位置,再给模型调用。 4. **创建 Skill,并绑定实际工具。** 描述它什么时候应该被调用、怎么提取参数、失败时如何处理。平台可以辅助生成内容,但仍要检查生成的规则,并把真实工具关联进去。只在文本里写“我能搜索思源”,不会自动产生搜索能力。 5. **绑定自己的耳机做真机测试。** 在设备管理中确认设备,按平台流程开启开发者模式,再通过 Skill 编辑页的“真机测试”绑定。先说一句独一无二的测试内容,然后回到思源找出来,核对正文和位置。[官方真机流程](https://device.qianwen.com/docs/qwen/6681505) 平台这份真机文档目前仍以眼镜表述为主;我的千问耳夹式耳机已经实际绑定并调用过普通 Skill。其他设备和接入方式,仍要看各自的支持情况。 以我使用过的思源日记接口为例,工具的配置核心是: ```text 方法:POST 路径:/api/block/appendDailyNoteBlock Header: Authorization: Token <自己的 API Token> Content-Type: application/json ``` ```json { "notebook": "<自己的目标笔记本 ID>", "dataType": "markdown", "data": "<用户明确要求记录的正文>" } ``` 其中,`notebook` 和 `dataType` 设为工具常量,`data` 由模型从口述中提取。笔记本要用真实 ID,可以先调用 `/api/notebook/lsNotebooks` 查询;认证格式和笔记本接口可对照[思源官方 API 文档](https://github.com/siyuan-note/siyuan/blob/master/docs/API.zh-CN.md)。 这里的日记追加属于思源内部内核接口,我在自己的部署版本上用过,升级后仍要重新验证兼容性。[该接口的官方记录](https://github.com/siyuan-note/siyuan/issues/10368) Skill 的规则可以从这样一段开始,再用平台里的真实工具引用替换对应操作: > 当用户明确说“写思源日记”“写思源笔记”“记到思源”时,将要保存的原文追加到指定笔记本的当天日记。保留原意,不补写经历。没有正文时先询问。普通聊天、搜索和总结不自动写入。核对本轮工具结果后再确认成功;超时或结果不明时,说明暂时无法确认,不自动重复写入。 这是一个起点。搜索、读取、文档漫步还需要各自的工具和对话规则:搜索结果要保留真实文档 ID,“第二篇”要对应刚才的列表,读取失败要说明,不能只凭一小段搜索摘要就假装读完全文。 如果更适合用思源原生 CLI 实现某个操作,就让 CLI 在自己的电脑或服务器上执行,再把经过限制的操作接成 API 或 MCP 工具。耳机负责提供语音入口,具体如何组织数据和执行操作,可以继续由自己设计。 直连时还有一件事要想清楚:把 Token 保存进千问插件,就是授权平台使用这个凭证访问思源。工具里固定一个笔记本,不等于 Token 本身只拥有这个笔记本的权限。公开分享时,可以分享规则、示例和接入方法;每个人的地址与凭证,应由本人配置在自己的私有副本里。 ## 下一步 比如从一篇读书笔记出发,顺着引用和反向链接听下去;听到某个观点,口述补充一段自己的理解,再存回对应位置。 或者把一段时间的 daily notes 按主题找出来,聊聊某个项目最近卡在哪里。需要保留的结论,由我明确说一句,再写回笔记。 我还想把这条语音入口接到服务器上的 Codex。最近在讨论的一个方案是:我通过耳机交代任务,任务先进入一个持久保存的任务池,再由 Codex 执行;有空时打开网页看板查看结果,出门时就直接问耳机进度。 > 对耳机交代任务 → 任务池 → 服务器上的 Codex → 网页看板查看结果,耳机查询进度 比如散步时想起一个还没处理的问题,我希望能说:“检查一下那个项目为什么启动失败,先分析原因,给我一份报告。”任务记下来以后,服务器继续做事。我回家再看分析过程和结果,中途也可以问一句“刚才那个任务做到哪了”。这是我想做的下一步,目前还没有完成整条链路的实测。 对我个人来说,这个方案比把执行都交给千问内置代理更有吸引力:我已经有 ChatGPT 订阅,并且日常深度使用,希望复用;项目文件、脚本和运行环境也在自己的服务器上。配置好相应权限后,Codex 可以在那里读文件、运行命令、改代码和做测试,最后留下能检查的结果。 这些还要逐项实现和测试。我愿意继续折腾,是因为需求可以由自己往下写。思源的开源和 CLI 给了我操作数据的办法,ChatGPT 帮我把想法落实成代码和规则,千问开放平台则提供了让耳机接进来的路径。 这次体验里,有读旧笔记读得很顺的时候,也有明明说了思源却跑去备忘录的时候。我希望它接下来能更稳定地理解“记到哪里”“读哪一篇”和“这次到底做没做成”。 毕竟,我最开始的愿望一直很具体:想记一句话的时候,能当场说出来,过后在自己的日记里找到它。少一点掏手机、找入口的折腾,就能多留下一点当时还热乎的想法。 --- 本文根据本人实际使用过程与截图整理,使用 ChatGPT / Codex 辅助梳理结构、整理技术步骤和润色,由本人修改;头图由 AI 生成。截图中的新闻与游戏回答保留当时原貌,不作为事实核查结论。 Loading...  我很喜欢在思源笔记里写 daily notes,也很讨厌为了记一句话,专门把手机掏出来。 今天发生了什么,孩子又有了什么变化,或者突然冒出来一个想法,我都希望留一点记录。这些内容往往很短,当下说得清楚,过一会儿再回想,就只剩一个模糊的印象。 但从“我想记一下”到真正写进笔记,中间还有一串动作:掏手机、解锁、打开思源、找到当天的日记,再开始输入。以前用思源手机端时,体验也有些不顺手。事情明明不大,做完这几步,想记录的热情已经被磨掉了一截。 所以看到千问 AI 耳机出来的时候,我首先想到的就是: > 我能不能直接说话,让它把内容记进我的思源? 我希望保留自己原来的笔记习惯:内容还在自己的思源里,同一天继续追加到同一篇日记。我只想把输入这一步变得省事一点。 这篇文章,就是围绕这个想法的一次实际折腾。日记写入已经有过真机口述、思源回读都对得上的记录,日常使用中也依然会卡壳。下面这些截图,来自我自己的使用过程。 ## 先记进去 我的思源部署在自己的服务器上,有可访问的 HTTPS 地址。通过千问硬件开放平台,我给耳机接了一个私有 Skill,让它在听到明确的记录要求后,调用思源接口,把口述正文追加到指定笔记本的当天日记。 测试时,我还说过一句“我很快乐”。这句话没什么技术含量,但后来回读思源,正文和返回标识都对得上。再往后,正式的 daily notes 也有了实际写入并回读成功的记录。 耳机这一侧接的是千问的工具调用;已经验证的日记写入走 HTTP API。思源的原生 CLI 则提供了另一种操作自己工作空间的方式,可以在电脑或服务器上执行,再把需要的操作封装成千问可调用的工具。 这一步的意义不止于用耳机操作原本就在使用的笔记系统:通过思源这个案例可以进一步推断,耳机有望成为触发自定义服务的入口,从而在不改变既有工作流的前提下,调用和串联更多个性化能力。 ## 自己动手改 思源是开源的,提供 API,也有原生 CLI。搜索、读写文档、每日笔记、引用关系、导入导出,都有可以继续利用的程序接口。配合 ChatGPT,我可以描述需求、查接口、改代码、测试,再把合适的功能接到耳机上。[思源官方 CLI 说明](https://github.com/siyuan-note/siyuan/blob/master/README.zh-CN.md) 所以,翻旧笔记、听内容、文档漫步,都是我沿着这条链路主动去设计的功能。日记只是最初的入口。只要语音到自己服务的链路能走通,我就能在自己的服务这一侧继续 DIY,再逐项验证耳机用起来是否合适。 现在这个“思源助手”,我给它安排了四件事: - 记日记:把明确要求保存的口述原文,追加到当天的日记。 - 找笔记:用关键词搜索自己的笔记,先告诉我找到了哪几篇。 - 听内容:选一篇概括,或者分段读原文。 - 文档漫步:从当前笔记继续找下一篇,支持继续读、换一篇、回到上一篇。 ## 听听旧笔记 我更在意的场景,是散步或骑车时,能顺手听听自己以前写过的东西。手机留在口袋里,随口说一个主题,让它找出几篇,再挑一篇听。那些写完以后很少再打开的记录,也就多了一个重新翻出来的机会。 这次我拿自己的旧日志试了试:搜到相关记录,概括指定笔记,继续听内容,再从当前这篇往下一篇“漫步”。下面这些,是当时成功接上的几个片段。  *先找出来:搜索返回了具体标题和位置,我可以据此选择想听的内容。*  *再看大意:明确说出笔记标题后,它概括了这篇成长日志的目录。*  *继续听内容:这是阅读回复的节选,后面还能接着要求读原文。*  *顺着往下走:说“从这篇开始文章漫步下一篇”,它接着讲了下一篇记录。* 我喜欢的是这种重听自己记录的方式。散步时想起一个主题,或者骑车时忽然想回顾一段经历,不必先决定要打开哪个文件夹。听到熟悉的片段,还可以接着问、换一篇;如果又冒出新想法,就明确说一句,把它补进今天的日记。 ## 骑车时聊什么 那次使用里,我还让它看看知乎热榜,聊了一条关于 DeepSeek 的新闻,后来又一路聊到《塞尔达传说:王国之泪》。 这些话题之间没什么严密的计划。我想到哪儿,就问到哪儿。热榜里有一条感兴趣的内容,可以继续追问;游戏里某段剧情没想明白,也可以接着聊。 值得表扬的是,收音很准,风噪几乎没有影响,沟通很顺畅。Qwen 3.8 Flash 应对日常的 Chat 得心应手。  *从知乎热榜聊到新闻疑问。截图保留的是当时的回答,里面的具体消息不能直接当作已经核实的事实。* 比如聊塞尔达时,我会问:林克和塞尔达为什么会在地下遇到加侬多夫?《王国之泪》和《旷野之息》是什么关系?再往下,又聊到时间线、格鲁德族,以及游戏里的支线人物。 对我来说,这种随口追问的方式挺自然。一个问题讲完,我往往又有了下一个问题,耳机可以顺着接下去。手机可以留在口袋里。  *一句“你刚刚还没讲完”,可以把话题继续接回来。截图涉及《王国之泪》剧情。* 不过,聊得顺不代表每句话都可靠。 有一个很明显的例子:我问的是“DeepSeek 是否开始封禁美国用户”,它回答的却是“美国政府是否限制使用 DeepSeek”。谁限制谁,方向变了,但它仍然很肯定地说“你判断得对”。 这种回答在耳机里尤其容易被顺着听过去。语气自然,信息也很多,稍不留意就会把它当成已经查明的结论。以后遇到新闻核查,我会更在意它有没有说清楚来源、日期,以及是否真的回答了原来的问题。游戏设定也一样,可以边聊边理解,具体细节仍有必要核对。 还有一个挺有意思的片段:我让千问把这次使用整理成一份 Markdown 文档。它先说需要一点时间,我随后继续聊游戏;过了一会儿,耳机里传来她告诉我任务写好了的通知。  *耳机里听到完成通知后,App 里也能看到生成的 Markdown 文件卡片。* 我喜欢这种用法:当下把想法说出来,长一点的内容留到方便的时候再看。当前这种异步让远程 Agent 代理干活的模式,还是比较实用的。 ## 也有不顺  *搜索返回了具体笔记;紧接着“概括一下第三篇”又没有接住。顺畅和卡壳,都在同一段真实记录里。* 这里也能看到问题:它有时能找到标题,却接不住“第三篇”“第二篇”这样的追问;换成完整标题,或者继续尝试,又能读出内容。 这类体验会打断兴致。原因可能包括 Skill 没有把候选编号和文档对应关系处理好、工具读取失败,或者上下文切换出了问题。还需要进一步定位。对使用者来说,感受很直接:我刚听完它列出的三篇,再说“第二篇”,它应该知道我指的是哪一篇。 这次还有一段很拧巴的体验。 我明确说了“写思源笔记”,App 中却显示成了系统“备忘录”。它随后问我要不要创建提醒,我说“不需要”,接下来又收到“已追加到思源今天的日记”的回复。 站在使用者的角度,我当时想做的事情很简单。但这几句来回,让“到底记到哪里了”变得不清楚。 这可能和我的 Skill 触发描述、对话规则写得不够周全有关,也可能涉及平台如何在不同能力之间选择,或者前一轮结果返回的时间。现在不能把原因全部推给某一边。 我能做的,是把规则写得更明确:哪些说法进入思源日记,哪些只是聊天;原文怎么保留;工具失败时怎么回答;只有拿到真实成功结果,才说已经写入。测试时还要回到思源核对,不能只听一句“记好了”。 ## 怎么接入 千问硬件开放平台提供了 Skill 开发、工具接入、调试和真机测试等入口,也支持把已有 API、MCP 等服务接成模型可以调用的工具。我这次先走的是 API 插件加私有 Skill 这条路线。[平台介绍](https://device.qianwen.com/docs/qwen/6679322) 整个调用过程可以简单理解为: > 对耳机说话 → 千问理解请求并选择 Skill → 调用配置好的外部工具 → 自己的服务执行操作 → 千问根据结果回复 想照着试,可以按下面的顺序来。 1. **准备自己的服务。** 对思源来说,需要自己的访问地址、API Token,以及明确的目标笔记本。地址要能被千问云端访问;电脑上只有一个本机地址,还不能让云端连进来。建议先用一个专门的测试笔记本。 2. **在开放平台创建 API 插件。** 进入[千问 AI 硬件开放平台](https://device.qianwen.com/),按页面要求完成开发者准备,在技能平台的“API 插件”里配置服务地址、认证方式和具体接口。地址、Token 都用自己的,不把私人凭证写进公开的 Skill 文本。 3. **把一次操作定义清楚。** 比如“追加当天日记”,只需要从口述中提取要记录的正文;目标笔记本固定在工具配置里。先在工具调试中验证它能写进正确的位置,再给模型调用。 4. **创建 Skill,并绑定实际工具。** 描述它什么时候应该被调用、怎么提取参数、失败时如何处理。平台可以辅助生成内容,但仍要检查生成的规则,并把真实工具关联进去。只在文本里写“我能搜索思源”,不会自动产生搜索能力。 5. **绑定自己的耳机做真机测试。** 在设备管理中确认设备,按平台流程开启开发者模式,再通过 Skill 编辑页的“真机测试”绑定。先说一句独一无二的测试内容,然后回到思源找出来,核对正文和位置。[官方真机流程](https://device.qianwen.com/docs/qwen/6681505) 平台这份真机文档目前仍以眼镜表述为主;我的千问耳夹式耳机已经实际绑定并调用过普通 Skill。其他设备和接入方式,仍要看各自的支持情况。 以我使用过的思源日记接口为例,工具的配置核心是: ```text 方法:POST 路径:/api/block/appendDailyNoteBlock Header: Authorization: Token <自己的 API Token> Content-Type: application/json ``` ```json { "notebook": "<自己的目标笔记本 ID>", "dataType": "markdown", "data": "<用户明确要求记录的正文>" } ``` 其中,`notebook` 和 `dataType` 设为工具常量,`data` 由模型从口述中提取。笔记本要用真实 ID,可以先调用 `/api/notebook/lsNotebooks` 查询;认证格式和笔记本接口可对照[思源官方 API 文档](https://github.com/siyuan-note/siyuan/blob/master/docs/API.zh-CN.md)。 这里的日记追加属于思源内部内核接口,我在自己的部署版本上用过,升级后仍要重新验证兼容性。[该接口的官方记录](https://github.com/siyuan-note/siyuan/issues/10368) Skill 的规则可以从这样一段开始,再用平台里的真实工具引用替换对应操作: > 当用户明确说“写思源日记”“写思源笔记”“记到思源”时,将要保存的原文追加到指定笔记本的当天日记。保留原意,不补写经历。没有正文时先询问。普通聊天、搜索和总结不自动写入。核对本轮工具结果后再确认成功;超时或结果不明时,说明暂时无法确认,不自动重复写入。 这是一个起点。搜索、读取、文档漫步还需要各自的工具和对话规则:搜索结果要保留真实文档 ID,“第二篇”要对应刚才的列表,读取失败要说明,不能只凭一小段搜索摘要就假装读完全文。 如果更适合用思源原生 CLI 实现某个操作,就让 CLI 在自己的电脑或服务器上执行,再把经过限制的操作接成 API 或 MCP 工具。耳机负责提供语音入口,具体如何组织数据和执行操作,可以继续由自己设计。 直连时还有一件事要想清楚:把 Token 保存进千问插件,就是授权平台使用这个凭证访问思源。工具里固定一个笔记本,不等于 Token 本身只拥有这个笔记本的权限。公开分享时,可以分享规则、示例和接入方法;每个人的地址与凭证,应由本人配置在自己的私有副本里。 ## 下一步 比如从一篇读书笔记出发,顺着引用和反向链接听下去;听到某个观点,口述补充一段自己的理解,再存回对应位置。 或者把一段时间的 daily notes 按主题找出来,聊聊某个项目最近卡在哪里。需要保留的结论,由我明确说一句,再写回笔记。 我还想把这条语音入口接到服务器上的 Codex。最近在讨论的一个方案是:我通过耳机交代任务,任务先进入一个持久保存的任务池,再由 Codex 执行;有空时打开网页看板查看结果,出门时就直接问耳机进度。 > 对耳机交代任务 → 任务池 → 服务器上的 Codex → 网页看板查看结果,耳机查询进度 比如散步时想起一个还没处理的问题,我希望能说:“检查一下那个项目为什么启动失败,先分析原因,给我一份报告。”任务记下来以后,服务器继续做事。我回家再看分析过程和结果,中途也可以问一句“刚才那个任务做到哪了”。这是我想做的下一步,目前还没有完成整条链路的实测。 对我个人来说,这个方案比把执行都交给千问内置代理更有吸引力:我已经有 ChatGPT 订阅,并且日常深度使用,希望复用;项目文件、脚本和运行环境也在自己的服务器上。配置好相应权限后,Codex 可以在那里读文件、运行命令、改代码和做测试,最后留下能检查的结果。 这些还要逐项实现和测试。我愿意继续折腾,是因为需求可以由自己往下写。思源的开源和 CLI 给了我操作数据的办法,ChatGPT 帮我把想法落实成代码和规则,千问开放平台则提供了让耳机接进来的路径。 这次体验里,有读旧笔记读得很顺的时候,也有明明说了思源却跑去备忘录的时候。我希望它接下来能更稳定地理解“记到哪里”“读哪一篇”和“这次到底做没做成”。 毕竟,我最开始的愿望一直很具体:想记一句话的时候,能当场说出来,过后在自己的日记里找到它。少一点掏手机、找入口的折腾,就能多留下一点当时还热乎的想法。 --- 本文根据本人实际使用过程与截图整理,使用 ChatGPT / Codex 辅助梳理结构、整理技术步骤和润色,由本人修改;头图由 AI 生成。截图中的新闻与游戏回答保留当时原貌,不作为事实核查结论。 最后修改:2026 年 10 月 21 日 © 允许规范转载 打赏 赞赏作者 支付宝微信 赞 1 如果觉得我的文章对你有用,请随意赞赏